跳至内容

Junyi's Lab

deciax:用 JAX 和 Pallas 在 TPU 上运行 Decision Model

给一条工单选部门、判断是否需要退款、给紧急程度打分,这些任务需要的是几个结构化判断。模型可以直接输出选项和概率,不必逐 token 生成一段回答。

Laya 就是这样一个 Decision Model:用一次前向计算处理选择、评分和是非问题。我把它的推理路径移植到了 JAX,做成了 deciax,让这类模型可以在 TPU 上运行,再用 Pallas 优化其中的计算。

这次测试里1,单芯片 TPU v6e 的英文模型单问题调用 p50 是 2.18 ms,多语言模型是 1.55 ms。作为对比,A100 SXM4、H100 PCIe、H200 NVL 的最快实测结果分别是 6.4 / 4.0 ms、4.8 / 3.2 ms、5.8 / 4.1 ms(英文 / 多语言)。

每次 50 个问题时,v6e Pallas 的 p50 是 33.69 / 17.83 ms,相较普通 JAX 实现提速约 2.3 倍;A100、H100、H200 的最快实测结果分别是 68.8 / 36.2 ms、44.0 / 23.2 ms、39.8 / 21.2 ms。
HLO Visualizer:把 XLA HLO 变成看得懂的图

调 JAX / TPU 程序的时候,迟早会碰到 HLO。想知道一个计算被编译成了什么、为什么多出几次 copy、一个 fusion 里到底装了哪些操作,最后都要打开编译器吐出来的那份文本。

指令里挤着 shape、layout、tiling、memory space 和 computation 引用,光认出 bf16 和 fusion 还远远不够。

所以我做了 HLO Visualizer:把 HLO 文本变成可以探索的图,点一下节点,就能把这条指令一块一块地读明白。

LLM Inference on TPU v6e-4: Small Dense, Large MoE, and Large Dense Models

# Abstract

We benchmark LLM inference on one Google TPU v6e-4 host (four chips, one VM). We use vLLM 0.20.0 with the tpu-inference backend and an fp8 KV cache.

We test three Qwen3 models:

ModelTypeParamsParallelismChips
Qwen3.5-4Bdense4B activetp11
Qwen3-30B-A3BMoE30B total / 3B activetp44
Qwen3-32Bdense32B activetp44

We measure three parts of inference: prefill, decode, and end-to-end online serving.

拆穿 introl 和 ainewshub,TPU 比 GPU 便宜 4 倍是 AI 编的幻觉

声明:这篇文章不是要论证 TPU 不如 GPU。TPU 和 GPU 各有适用场景,谁强谁弱要看具体负载。我要说的是,目前网上流传的那批对比数据本身不准确,很多是 AI 编造、无法溯源的。下面拆的就是这些假数据。

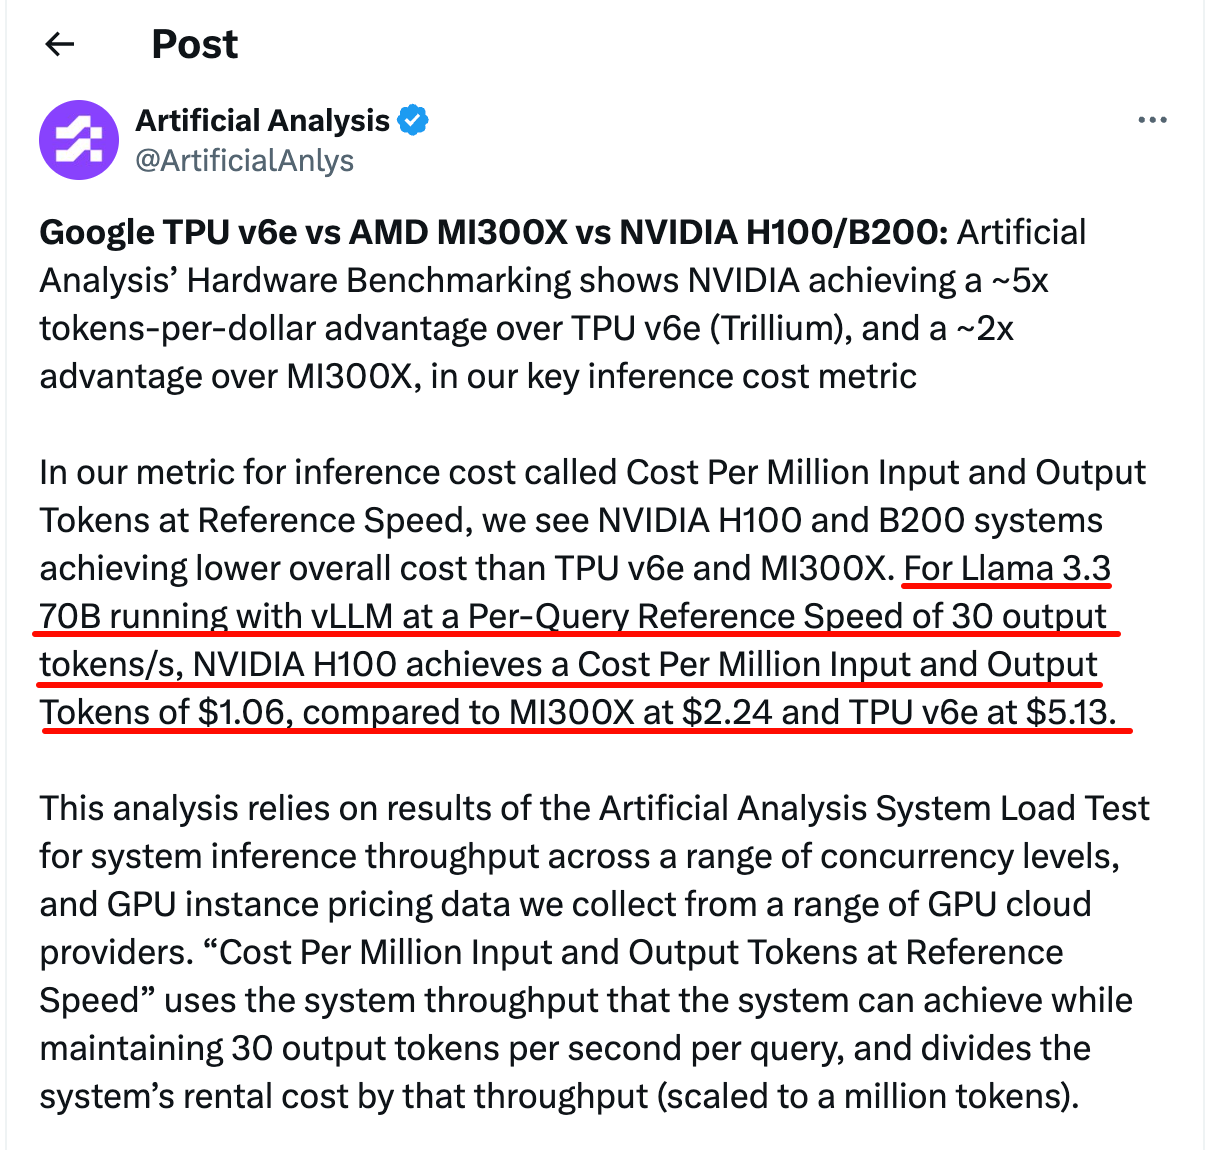
Artificial Analysis 最近放出一组硬件基准测试1,以 Llama 3.3 70B、vLLM、每查询 30 output tokens/s 的参考速度计算每百万输入输出 token 的成本,NVIDIA 对 TPU v6e (Trillium) 有大约 5 倍的每美元 token 优势,对 AMD MI300X 有大约 2 倍优势2。

Artificial Analysis 在 X 上公布的硬件基准结论

Artificial Analysis 在 X 上公布的硬件基准结论,NVIDIA 对 TPU v6e 有约 5 倍每美元 token 优势,对 MI300X 约 2 倍,H100 是 1.06 美元,MI300X 是 2.24 美元,TPU v6e 是 5.13 美元。

跟这些能复现的数据一起在网上传的,还有另一类东西。

# 一篇高调的对比文

introl 有一篇文章,标题叫 Google TPU v6e vs GPU: 4x Better AI Performance Per Dollar3。核心论点是 TPU 每美元性能比 H100 好 4 倍,TPU 在推理经济性上全面压过 NVIDIA。它的关键数据来自另一篇文章,ainewshub.org 的 Nvidia vs Google TPU 2025 Cost Comparison4。顺着这条引用链往下看,会发现两篇都是 AI 生成的,数据是编的。

Claude Code 在 tmux 里要求重新登录?八成是 macOS Keychain 的锅

终端里 claude 好好的,Team Account 也认得,进了 tmux 就让我重新登录。折腾了一会儿才发现是 macOS Security Session 的老问题。

Agent Mesh:聊聊我对多 AI 协同工作流的一些想法

现在 AI 编程助手越来越多,从聊天框一路卷到了跑在命令行里的 Agent。用了一圈下来,我最大的感受是:没有哪个 Agent 能在所有方面都做到最好。

我日常主要在用 Claude Code、Google Gemini CLI 和 Moonshot Kimi Code。一开始也是把它们当独立工具用,后来发现这样太浪费了,因为它们各有各的长板,如果让它们根据各自的优势互相配合、互相委派任务,效果会好很多。我把这个思路叫做 Agent Mesh。

用 nerdctl + Tailscale Sidecar 让容器流量走 Exit Node:踩坑全记录

在容器化部署中,有时候我们需要让容器的所有出站流量通过特定的网络出口。Tailscale 的 sidecar 模式可以做到这一点:用一个 Tailscale 容器作为 sidecar,其他容器共享它的网络命名空间,流量通过 WireGuard 隧道经由远端 exit node 出去。

这个方案在 Docker Compose 下很成熟,但迁移到 nerdctl(containerd)时,我踩了一连串的坑。记录下来,希望能帮后来人少走弯路。

从像素到笔触:跨越十年的凝视

into-the-modern
INTO THE MODERN

2026 年初,我在新加坡 “INTO THE MODERN” 印象派画展中,第一次站在莫奈Monet的原作前。

用 Dev Container 配置 VS Code + LaTeX 环境

这套配置用 Dev Container1 管理 LaTeX 环境,用 Git 同步项目。拉取仓库后,在容器中打开即可编译。